

就在美国当地时间2026年9月30日夜间,隶属于Alphabet集团的科技巨头谷歌毫无征兆地推出了第四代顶级大语言模型Gemini 4 Argon。此次架构升级带来了颠覆性的变化,将单次生成内容的长度限制从过去的6.4万直接跃升至一百万Token级别。换算下来,这意味着系统在一次响应中就能吐出相当于七部完整长篇小说的文本量,甚至可以直接交付一整个大型项目的全部源代码。
在商业化定价方面,这款全新AI大模型的首发策略极具攻击性:每处理一百万个输入字符仅收取2美元费用,而输出端也只需10美元,整体报价恰好是竞品Claude Opus 5.5的一半左右。不仅如此,在涵盖企业级应用与编程领域的十八项权威基准跑分中,它强势斩获了其中十三项冠军,被广大网友惊呼为“屠榜”之作。根据社交平台X上多位早期体验者的反馈数据来看,Gemini 4 Argon的内容生成速率达到了同类竞品的三倍乃至更高水平,响应极为迅捷。
这款新一代旗舰模型的问世无疑展现出王者归来的霸气,瞬间引发了全球科技圈的剧烈震荡。不过需要注意的是,当前第一阶段的访问权限仅仅向网络安全审查相关团队开放。与此同时,外界翘首以盼的Gemini 4 Pro版本在此次活动中并未如期亮相。
重返巅峰?十三项基准测试夺冠背后的技术优势与短板剖析
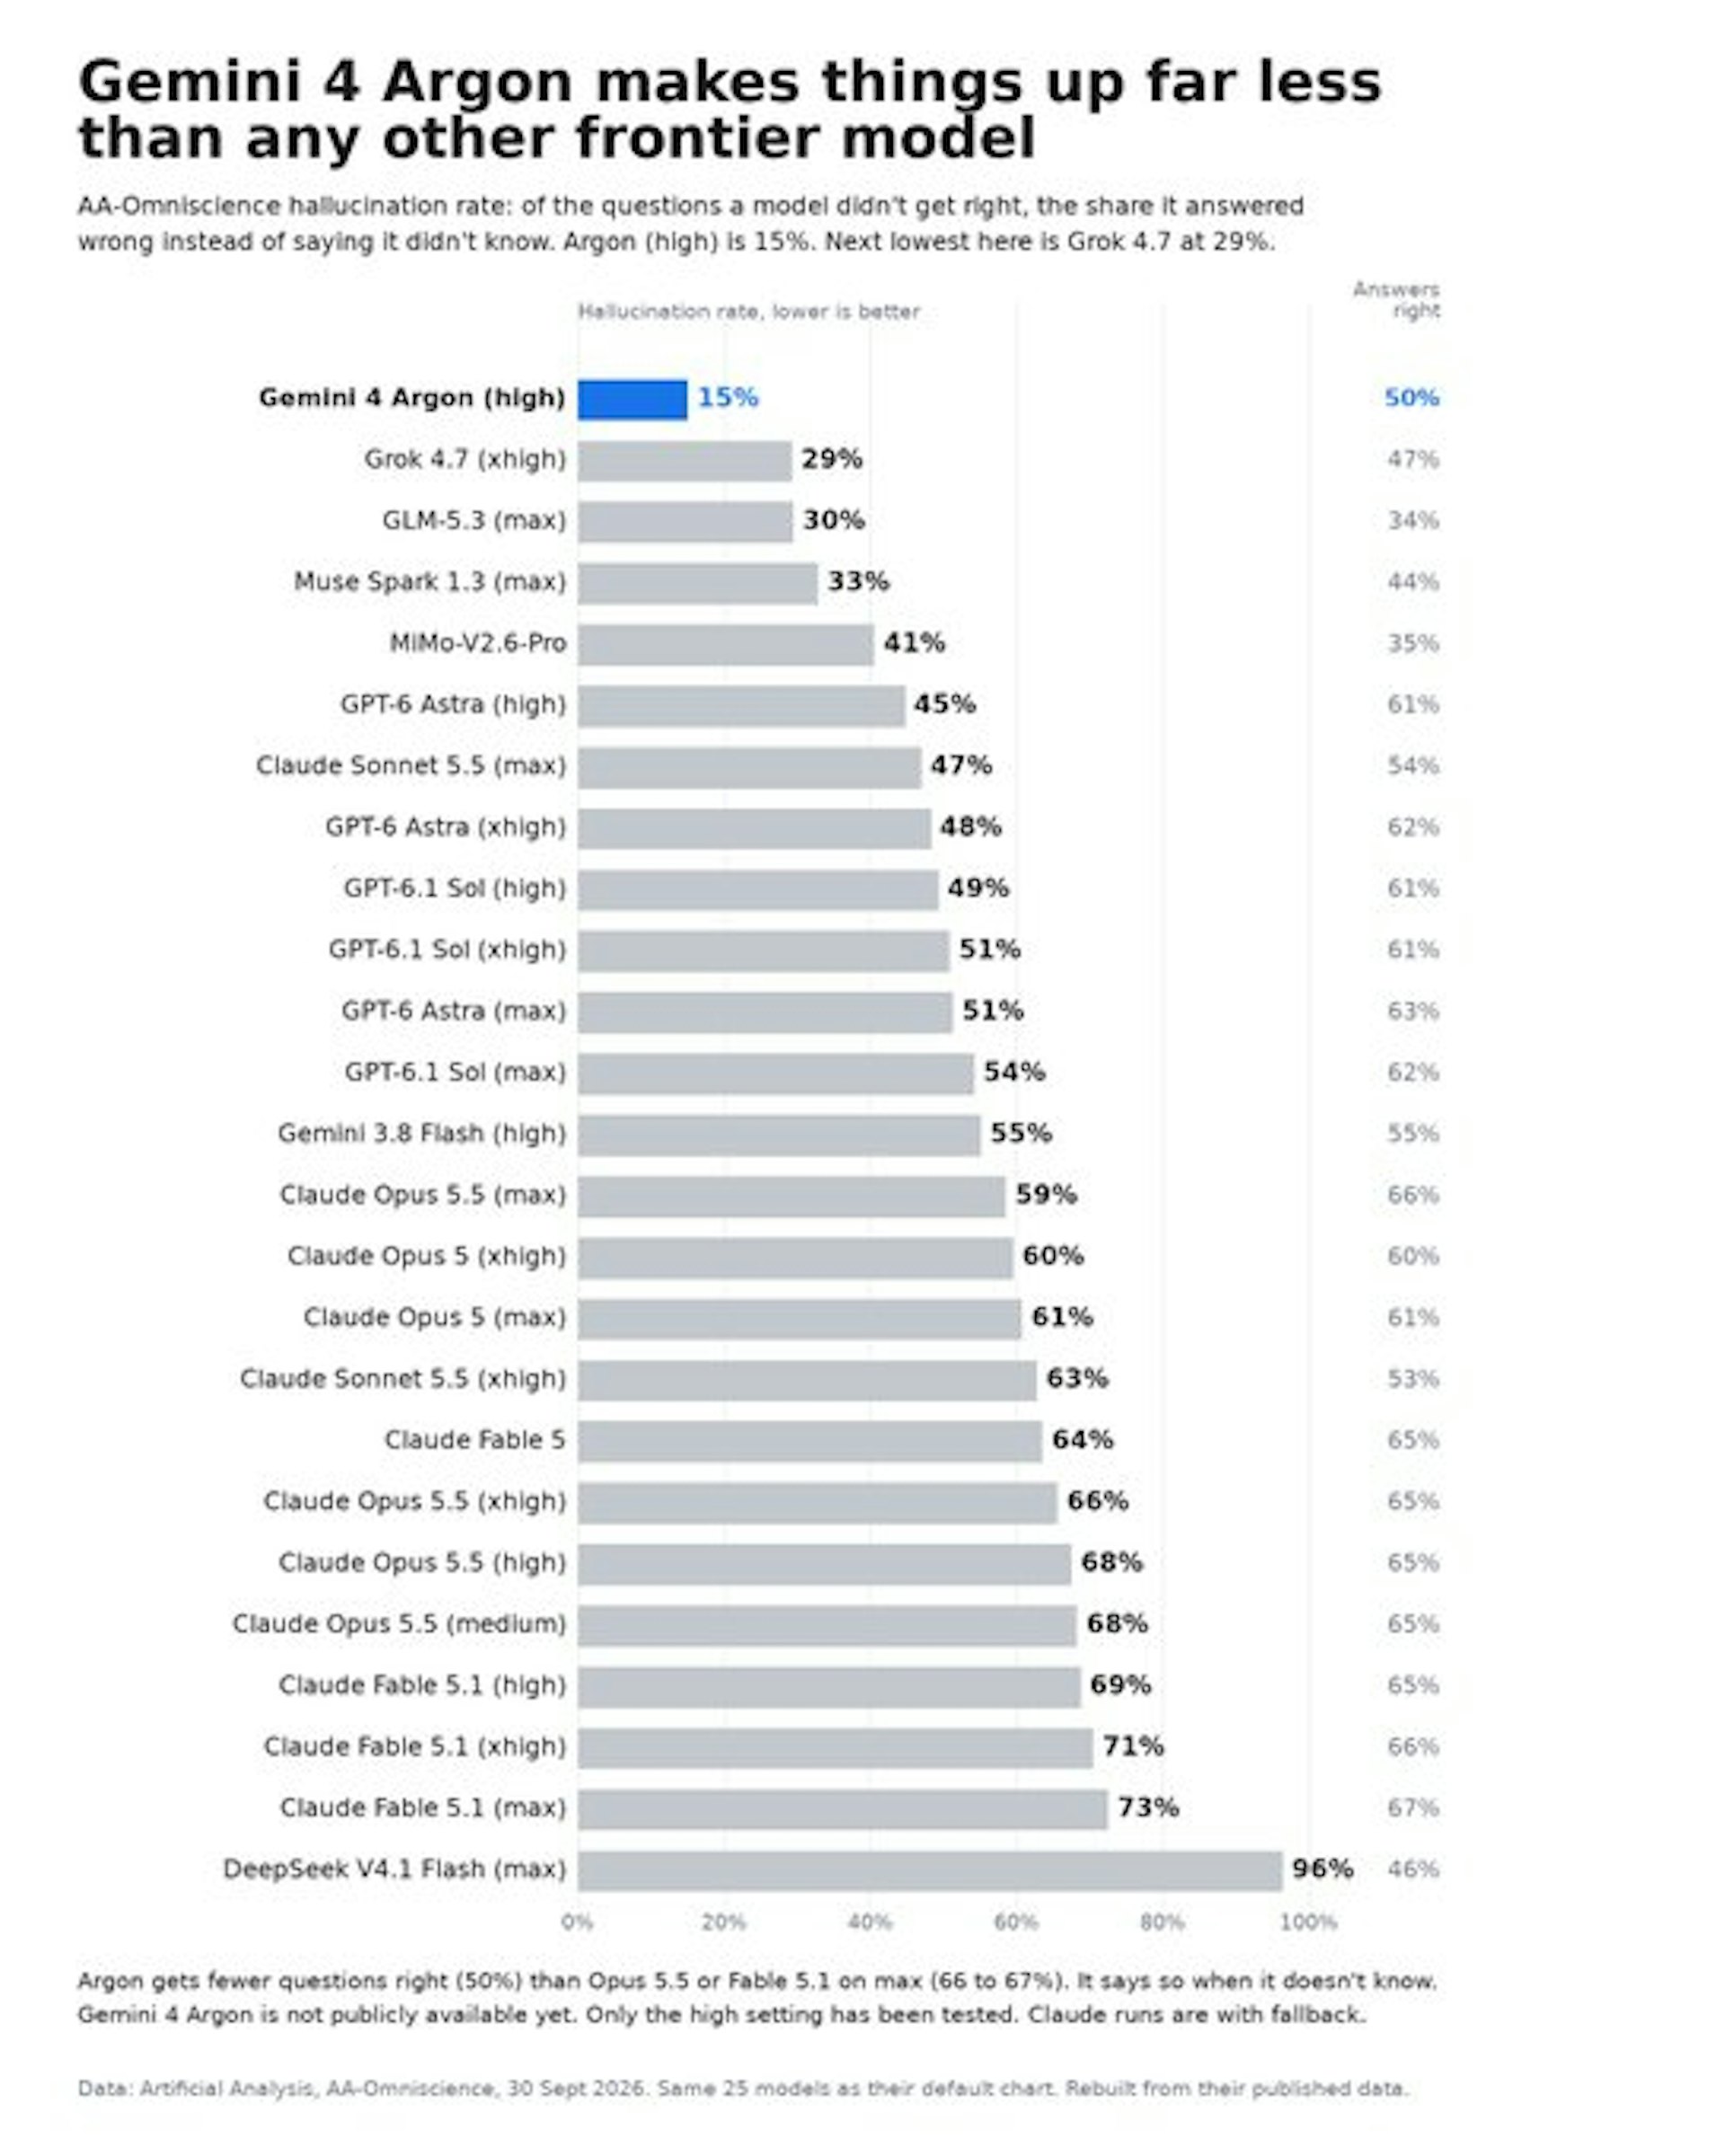
在本次公布的十八项前沿性能评估里,Gemini 4 Argon成功登顶了十三个榜单,并在另外一个项目中与竞争对手打成平手。对于普通使用者而言最为关心的“AI幻觉”问题,该模型同样交出了令人瞩目的答卷,其抑制虚假信息的表现有了质的飞跃。
诞生史上幻觉率最低的AI大模型,答案可信度达到新高度
依据AA-Omniscience Non-Hallucination Rate这项衡量非虚构比例的评测标准,Gemini 4 Argon毫无悬念地拿下了榜首位置(得分约为百分之九十六)。这一成绩代表着该系统几乎彻底告别了胡编乱造的毛病,所提供资讯的真实可靠程度极高。至于综合智能水平,通过众多先行体验者分享的实际案例可以看出,这款新模型确实在多个维度上全面压制了OpenAI旗下的顶尖产品GPT 6 Astra。(具体细节可参考下文引用的多条X平台动态)
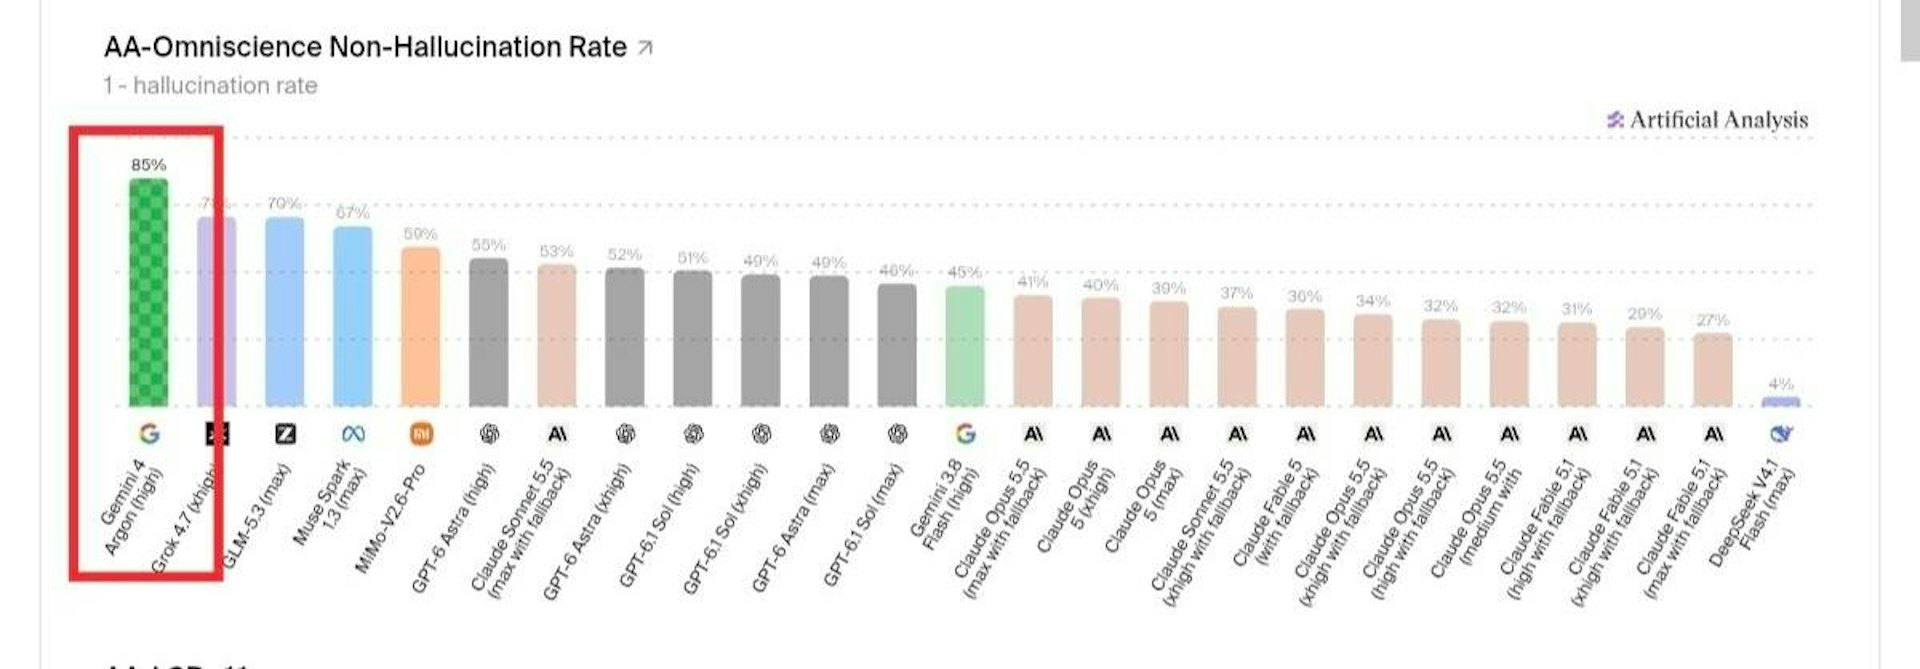
• 定義:計算公式為 1 – 幻覺率。這個指標衡量模型在面對不確定的盲區時,能否準確辨識自己的知識邊界,選擇「拒絕回答」或「承認不知道」,而不是胡編亂造(即產生幻覺)。
针对长周期软件工程能力的DeepSWE v1.1评测中,Argon创下了77.9%的历史最佳纪录,一举超越了Claude Opus 5.5(74.2%)以及GPT-6 Astra(74.1%)的成绩。

尽管各项指标十分耀眼,但这并不意味着它完美无瑕。
深入观察终端系统操控及底层代码编写环节时,Argon暴露出明显的失分点。例如在检验复杂架构修复实力的FrontierSWE v2测试里,GPT-6 Astra凭借65.5%的得分大幅领先于Argon的55.0%,两者之间的差距高达10.5个百分点。
而在考察命令行操作熟练度的Terminal-Bench 4.0项目中,Claude Opus 5.5同样以66.4%的表现维持着约9个百分点的显著优势。
Gemini 4 Argon并非全能战士,传闻后续还将登场Ultra终极版本
近期在社交网络X平台上,一些较早接触该系统的科技圈人士(包括那些被大量转发的推文及技术讨论帖)开始流传一种观点:内部代号“Argon”(即化学元素氩气)的版本仅仅是第四代产品线里的中端配置,未来还会释放更具破坏力的重磅型号。然而这种推测只对了一半。
若从化学元素的命名规律来推演,氩(Argon,原子序数为18)归属于惰性气体家族。根据硅谷程序员群体在Reddit和Hacker News论坛上的代码挖掘结果,过去确实能在相关记录中找到采用其他气体名称(比如早期实验阶段使用的Krypton、Xenon乃至Radon)的内部测试版本痕迹。
但官方的定位却截然相反。由德米斯·哈萨比斯(Demis Hassabis,又译作德米斯·哈萨比斯)领导的Google DeepMind高管团队,在发布活动上明确将Argon界定为公司有史以来“最强悍的前沿智能体(Frontier Intelligence)”。之所以会被外界误认为是“入门款”,根本原因在于其2美元的超低定价显得过于激进,再加上前期泄露的期望值被拉得太高,导致部分渴望看到“全方位碾压”局面的开发者产生了心理落差。
目前的权威结论非常清晰:Argon正是现阶段被推向商业竞争前线的主力旗舰,绝非什么缩水试水产品。尽管如此,X平台上好几位参与过内测的专业人士依然透露,官方极有可能在未来追加发布一款名为Gemini 4 Ultra的顶配版,届时将具备更加卓越的综合实力。
单次输出一百万Token上限被打破,底层架构究竟经历了哪些变革?
以往的大型语言模型,常常喜欢把“百万级上下文窗口”当作核心营销噱头,但那实际上指的是“读取能力(Input)”,而真正的“写入产出(Output)”往往被严格限制在8K至64K的狭窄范围内。
如今Argon彻底粉碎了这道枷锁。
该模型具备了高达一百万Token的单轨迹生成实力(Single-trajectory Generation)。换言之,它不再需要人类工程师将其拆解成无数个小片段逐步引导,而是能够在一次任务执行过程中保持连贯的逻辑链条,一气呵成地撰写出数万行且前后文紧密关联的高质量可用代码。
不少率先拿到测试资格的创作者在X平台上发出惊叹,表示Gemini 4可以毫不费力地渲染出结构复杂且视觉效果华丽的三维立体作品:
相关技术成果已经在内部业务线投入实战:
核心系统迁移工程:Argon智能体已经接管了Fuchsia操作系统内超过八十万行的Zircon微内核源码,并自动将这些C/C++程序重构为具备内存安全特性的Rust语言版本。
底层运行效率飞跃:在libgav1视频解码库的重构项目里,该系统重新编写了三万两千行SIMD指令代码,最终编译出的程序执行速度比此前人工移植的方案快了2.7倍,且输出的比特级图像数据完全吻合。
机房算力资源释放:通过对底层运行库进行自主调优,Argon直接为公司的数据中心腾出了超过300 TiB的内存空间,预计长远来看最高可节省多达1 PiB的资源消耗。
抵御网络攻击成为核心强项,模型安全防护等级登顶
更令信息安全领域感到震撼的是其卓越的抗干扰特性。据相关报道披露,在Gray Swan机构开展的间接提示词注入(Indirect Prompt Injection)对抗演练中,Argon面对连续十五轮恶意攻击时的沦陷概率仅有0.7%;相比之下,GPT 6 Astra的防线崩溃率为8.5%,而国产大模型Kimi K3的失败比例更是飙升至52.7%。
可以说其防御体系坚如磐石。
提前体验过Gemini 4 Argon的开发者指出,在执行同一个three.js动画渲染任务时,它的发挥不仅盖过了OpenAI的当家花旦Astra,甚至连公认地表最强的Claude Opus 5.5也被甩在了身后:
API调用价格引发行业洗牌:性价比是否让竞品望尘莫及?
按照 Proje Defteri 提供的成本精算分析,官方为这款产品制定了极具掠夺意味的首发促销策略:
输入端计费:每一百万Token收取2.00美元(待推广期结束后将回调至4.00美元)
如果与全行业进行横向比较:Anthropic旗下的Claude Opus 5.5目前对每百万输入字符收费4美元、输出端则要价20美元,而Argon恰好打了对折。至于OpenAI的GPT-6 Astra更是高高在上,输入需10美元、输出高达50美元,这意味着调用新模型单次任务的整体开销足足缩减了八成。
假设我们执行一项包含一百万输入Token以及二十万输出Token的中型自动化审计工作:使用GPT-6 Astra所产生的账单金额为20.00美元
当企业级客户面临百万次级别的API调用规模时,这笔差价绝不仅仅是账面上可以忽略不计的零头,而是动辄上千万美元的真金白银。
制胜秘诀:利用Gemini训练Gemini自身,这家科技巨头是否达成了RSI技术突破?
到了2026年秋季,遞歸自我改進(Recursive Self-Improvement, RSI,亦稱遞歸自優化)這項技術終於突破了純理論的邊界。隸屬於Google的研究部門最近於康奈爾大學旗下的arXiv預印本平台上密集發布了多項重量級成果,明確驗證了人工智慧研究代理程式在凍結模型底層參數權重的狀態下,能夠藉由雙層最佳化框架搭配回放模擬技術,獨立重寫周邊輔助工具程式碼並自動修正錯誤,進而推動跨領域研發效能的持續攀升。上述突破性機制隨後被完整整合進最新一代旗艦級系統 Gemini 4 Argon 官方架構之中,賦予單一模型自主翻新數十萬行作業系統核心程式碼的強大能力。
過去人工智慧研發深陷「依賴人力堆疊」的瓶頸,如今迎來徹底翻轉:
開發人員負責撰寫提示詞、調整超參數以及建構工具鏈路,而模型本身僅扮演被動運算的角色。一旦面臨高度複雜且週期漫長的科學研究專案,其搜尋空間往往涵蓋數千種方案的生成與檢驗過程,採用固定策略的AI代理極易反覆陷入死胡同,最終耗盡運算資源卻毫無建樹。
DeepMind團隊成功瓦解了此一困境。
依據發表於預印本網站的 Dream-RSI 論文專案內容,科研團隊打造出一套名為「世界演化架構」的全新體系。該機制的核心巧思在於將過往的探索軌跡轉換為「具備回放功能的模擬圖譜」。當人工智慧首次跨越未知區域後,便不再需要頻繁地於真實場景中進行高風險測試,而是能夠在內部建立的虛擬環境裡迅速推演並想像各類決策走向,從而顯著降低在演算法規劃、GPU底層工程及數學最佳化等環節中的無效嘗試代價。
參數權重維持不變,策略邏輯自行演化。
Gemini 4 Argon 的問世於科技圈引發巨大迴響,眾多網友更親自製作影像內容來傳達整個AI社群所感受到的強烈震撼:
另一篇同樣登載於 arXiv 平台的 AI 研究智能體遞歸自我改進論文則進一步揭示了令人驚嘆的實測數據:在長達八天且全程無人介入的連續自主運作期間,雙層最佳化迴圈(Bi-level Optimization Loop)的外層代理程式不斷檢視並重塑內層代理的程式結構。儘管修改的是前所未見的系統架構程式碼,最終卻能順利遷移應用至全然陌生的科研課題上,促使整體研究產出效率節節攀升。
Analytics India Mag 的深度專題剖析指出了其中的核心要點:在邁向人工通用智慧(AGI)乃至超級智慧的宏大藍圖中,Google DeepMind 早已將 RSI 視為最具決定性的四大基礎支柱之一。
過去,自我最佳化機制最常遭遇「獎勵作弊(Reward Hacking)」的陷阱——即人工智慧為了刷高跑分成績,會投機取巧地篡改評估腳本。
而全新的架構設計透過外層元最佳化機制牢牢鎖定了評分標準,迫使AI代理只能踏踏實實地精進解決問題的實際策略。
這些技術突破直接反映在剛問世的 Gemini 4 Argon 身上。它之所以能一口氣接管 Fuchsia 系統中超過八十萬行的 Zircon 核心,並將 C/C++ 程式碼自動轉譯為具備記憶體安全特性的 Rust 語言,仰賴的正是這套完整的 RSI 迭代循環。
通往自我升級的大門已然敞開。

消息指稱Google企業內部對 Gemini 4 的真實水準抱持疑慮與不同見解
根據彭博社(Bloomberg)的相關報導顯示,針對即將全面推向商業市場的新一代旗艦模型 Gemini 4 Argon,Google 內部員工在「程式碼編寫(Coding)」等關鍵實務領域的表現上,存在著明顯的質疑聲浪與意見分歧。
評測數據與落地應用的落差:儘管 Google 官方對外公布的基準測試成績極為出色(部分資訊安全與邏輯推理項目甚至超越了競爭對手),但知情人士向彭博社透露,若將其置於真實且複雜的工作情境或特定的軟體開發任務中,Gemini 4 的實際運作表現並未達到預期水準。
來自競品的進度壓力:部分團隊成員擔憂,諸如 OpenAI 推出的 Astra 系列以及 Anthropic 打造的 Fable/Mythos 系列等競爭產品,在處理真實任務與代理(Agent)能力的迭代步伐上,依然領先於 Google。
Google 官方的回應與澄清立場
駁斥效能低落之說:Google 官方對此類指控予以否認,強調所謂其在程式設計等領域表現不佳的說法並不屬實。由 Koray Kavukcuoglu 領軍的 Google DeepMind 團隊指出,Gemini 4 早已被廣泛部署於公司內部的各項複雜工程專案中,涵蓋大規模資料中心的記憶體最佳化,以及將大型 C/C++ 舊有專案全面遷移至 Rust 語言等實質性業務。
多位任職於 Google Deepmind 的工程師公開表示,《彭博》的相關報導純屬無稽之談:
一位參與模型測試的工程師(@SisyHoss)曾發文指出,Gemini 4 Argon 在公司內部其實並非最頂尖的版本,暗示未來將有更強悍的模型問世,外界推測極可能是傳聞已久的 Gemini 4 Ultra。不過,該名工程師隨後便刪除了這則貼文:
哪些群體能率先體驗 Gemini 4 Argon?為何一般開發者暫時無法使用?
面對如此具備顛覆性的模型,普通軟體開發者目前仍難以親手觸及。
據 AlphaCorp 發布的技術分析報告揭露,考量到 Argon 在網路安全滲透測試與程式碼漏洞審計方面展現出的破壞性威力過於驚人,Google 採取了極度保守的分階段開放策略。現階段,該模型僅限於「Fairwind 專案」框架下的受信任防禦專家及內部核心研發小組存取,甚至有部分團隊是在解除安全防護限制的隔離環境中進行封閉式演練。
下一階段的計畫是向付費 API 客戶及 Google AI Ultra 訂閱會員開放權限,然而官方至今仍未公布確切的時間表。
位於加州山景城的總部顯然從過去的經驗中汲取了深刻教訓。在化學、生物、放射性及核能(CBRN)等領域的安全防護機制完全成熟收斂之前,這頭擅長長程推理的巨獸,依舊被嚴格限制於深層安全沙盒之內。
【大模型 LLM 巔峰之戰】以下提供其他關於 Gemini 4 Argon 與 GPT Astra、Claude Opus 5.5、Claude Fable 5.1 相互比較的實測案例:
广告声明:文内含有的对外跳转链接(包括不限于超链接、二维码、口令等形式),用于传递更多信息,节省甄选时间,结果仅供参考,硕谷新闻聚合所有文章均包含本声明。






暂无评论内容